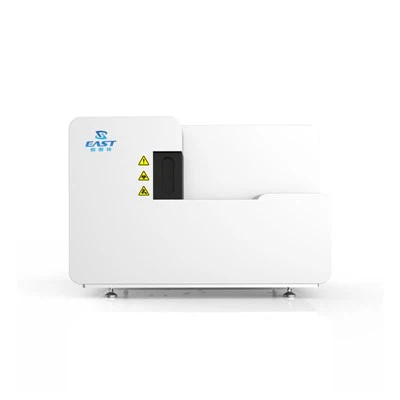

В области микробиологии и различных других научных дисциплин, анализ кривых роста имеет решающее значение для понимания развития и поведения организмов или процессов с течением времени. Как поставщикАвтоматический анализатор кривой роста микробовиАнализатор кривой роста микробов, мы часто сталкиваемся с данными с разными масштабами. В этом сообщении мы рассмотрим, как наш анализатор кривой роста эффективно обрабатывает такие данные.
Понимание данных с разными масштабами
Данные в анализе кривой роста могут исходить из широкого спектра источников и могут иметь совершенно разные масштабы. Например, в исследованиях роста микробов мы можем измерить такие параметры, как оптическая плотность (OD), которая обычно варьируется от почти нулевого до нескольких единиц, и количество клеток, которые могут охватывать от нескольких сотен до миллионов или даже миллиардов клеток на миллилитр. Кроме того, интервалы времени могут варьироваться от нескольких минут до нескольких часов или дней, в зависимости от характера эксперимента.
Эти различия в масштабе могут представлять значительные проблемы в анализе данных. Если не обрабатываться должным образом, они могут привести к неточным интерпретациям, трудностям в визуализации данных и проблемам со статистическим анализом. Например, при построении кривой роста с данными по количеству ячеек и OD на одном и том же графике без соответствующего масштабирования одна переменная может доминировать на графике, что затрудняет наблюдение за тенденциями другой переменной.
Предварительные методы обработки
В нашем анализаторе кривой роста используется несколько методов предварительной обработки для обработки данных с различными масштабами. Одним из наиболее распространенных методов является нормализация. Нормализация - это процесс преобразования данных, так что они попадают в определенное диапазон, обычно от 0 до 1. Это облегчает сравнение различных переменных и гарантирует, что ни одна переменная не оказывает чрезмерного влияния на анализ.
В нашем анализаторе доступны различные типы методов нормализации. Одним из них является минимальная нормализация, которая вычисляет минимальные и максимальные значения набора данных, а затем масштабирует каждую точку данных в соответствии с формулой:


[x_ {norm} = \ frac {x - x_ {min}} {x_ {max} -x_ {min}}]]
где (x) является исходной точкой данных, (x_ {min}) является минимальным значением в наборе данных, а (x_ {max}) является максимальным значением.
Другим полезным методом нормализации является нормализация Z - оценки. Этот метод стандартизирует данные путем вычитания среднего значения набора данных и деления на стандартное отклонение. Формула для нормализации Z - оценка:
[z = \ frac {x- \ mu} {\ sigma}]
где (x) является исходной точкой данных, (\ mu) является средним значением набора данных, а (\ sigma) является стандартным отклонением. Z - нормализация баллов особенно полезна, когда данные следует за нормальным распределением, так как позволяет легко сравнивать точки данных с точки зрения их расстояния от среднего.
В дополнение к нормализации, наш анализатор также предлагает варианты преобразования данных. Например, логарифмическое преобразование может быть применено к данным, которые имеют широкий диапазон значений. Принятие логарифма данных может сжать шкалу и облегчить анализ. Это особенно полезно для таких переменных, как количество клеток, которые могут иметь экспоненциальные модели роста.
Адаптивное масштабирование в визуализации
Визуализация кривых роста является неотъемлемой частью процесса анализа. Наш анализатор кривой роста обеспечивает адаптивные возможности масштабирования в своих инструментах визуализации. Когда на одном и том же графике построены несколько переменных с разными шкалами, анализатор автоматически регулирует оси, чтобы убедиться, что все данные четко видны.
Например, если мы планируем подсчет OD и ячейки на одном и том же графике, анализатор будет использовать систему с двойной оси. Одна ось будет использоваться для значений OD, а другая для количества ячеек. Шкалы каждой оси регулируются независимо, чтобы эффективно показать тенденции обеих переменных. Это позволяет исследователям легко наблюдать за взаимосвязи между различными переменными с течением времени.
Кроме того, анализатор также предоставляет варианты масштабирования и панорамирования. Исследователи могут увеличить конкретные области кривой роста, чтобы исследовать детали, а также пройти через график, чтобы просмотреть различные временные интервалы. Эта интерактивная функция визуализации облегчает изучение данных и выявление важных закономерностей.
Статистический анализ по масштабированным данным
Как только данные предварительно обработаны и визуализированы, наш анализатор кривой роста выполняет различные статистические анализы. Эти анализы предназначены для эффективной работы с масштабированными данными. Например, регрессионный анализ может быть использован для моделирования взаимосвязи между различными переменными в кривой роста. Наш анализатор может выполнять линейную регрессию, полиномиальную регрессию и не -линейную регрессию на масштабированных данных, чтобы соответствовать наилучшей кривой.
Статистические тесты, такие как T -тесты и ANOVA, также могут применяться к масштабированным данным, чтобы определить, существуют ли существенные различия между различными условиями роста или экспериментальными группами. Эти тесты имеют решающее значение для вывода значимых выводов из данных.
Анализатор также рассчитывает важные параметры, такие как скорость роста, продолжительность фазы задержки и продолжительность стационарной фазы. Эти параметры рассчитываются на основе масштабированных данных, гарантируя, что они являются точными и сопоставимыми в разных экспериментах.
Обработка недостающих данных с разными масштабами
Пропущенные данные являются еще одной распространенной проблемой в анализе кривой роста, и это может быть еще более сложным при работе с данными различных масштабов. Наш анализатор кривой роста был создан - в алгоритмах для обработки недостающих данных. Одним из подходов является использование методов интерполяции. Например, линейная интерполяция может использоваться для оценки пропущенных точек данных на основе значений соседних точек.
В тех случаях, когда в данных существуют большие пробелы, могут использоваться более продвинутые методы, такие как интерполяция сплайн или регрессия. Эти методы учитывают общую тенденцию данных и взаимосвязь между различными переменными для оценки пропущенных значений.
Наш анализатор также позволяет пользователям указать различные стратегии для обработки недостающих данных в зависимости от характера эксперимента и масштаба данных. Например, в некоторых случаях может быть целесообразно просто исключить точки данных с пропущенными значениями, в то время как в других случаях вменение может быть лучшим вариантом.
Тематические исследования
Чтобы проиллюстрировать, как наш анализатор кривой роста обрабатывает данные с различными масштабами в реальных сценариях мира, давайте рассмотрим несколько тематических исследований.
В исследовании роста бактерий в различных средах исследователи измерили как количество OD, так и клеток с течением времени. Количество ячеек варьировалось от нескольких тысяч до миллионов, в то время как значения OD составляли от 0 до 2. Использование нашего анализатора, данные сначала были нормализованы с использованием нормализации MIN -MAX. Затем кривые роста для количества OD и клеток были нанесены на график с двойной осью. Адаптивная масштабирующая особенность анализатора позволила легко наблюдать за тенденциями обеих переменных.
Статистический анализ был затем выполнен на масштабированных данных. Регрессионный анализ показал сильную положительную связь между количеством OD и клеток, что указывает на то, что OD может использоваться в качестве надежного прокси для роста клеток в этом конкретном эксперименте. Рассчитанная скорость роста и продолжительность фазы задержки также соответствовали предыдущим исследованиям, демонстрируя точность анализа на масштабированных данных.
В другом случае исследовательская группа изучала рост дрожжей в различных температурных условиях. У них были данные о потреблении глюкозы, которые имели широкий диапазон значений и жизнеспособность клеток, которые выражались в процентах. Анализатор применил логарифмическое преобразование к данным потребления глюкозы и нормализации баллов к данным жизнеспособности ячейки. После визуализации и статистического анализа исследователи смогли определить оптимальную температуру для роста дрожжей на основе комбинированных тенденций потребления глюкозы и жизнеспособности клеток.
Заключение
Обработка данных с различными масштабами является сложной, но важной задачей в анализе кривой роста. Наш анализатор кривой роста, как ведущее решение на рынке, предлагает комплексный набор инструментов и методов для решения этой проблемы. От предварительных методов обработки, таких как нормализация и преобразование данных, до адаптивного масштабирования в визуализации и статистическом анализе по масштабированным данным, наш анализатор предоставляет исследователям средства для точного анализа кривых роста и делать значимые выводы.
Если вы заинтересованы в расширении возможностей анализа кривой роста и нуждаетесь в надежном анализаторе кривой роста, мы приглашаем вас связаться с нами для обсуждения закупок. Наша команда экспертов готова помочь вам найти лучшее решение для ваших конкретных потребностей в исследованиях.
Ссылки
- Altman, DG, & Bland, JM (1995). Статистические примечания: отсутствие доказательств не является доказательством отсутствия. BMJ, 311 (7003), 485 - 485.
- Box, Gep, & Cox, DR (1964). Анализ трансформаций. Журнал Королевского статистического общества: серия B (методологический), 26 (2), 211 - 252.
- Draper, NR, & Smith, H. (1998). Применяемый регрессионный анализ (том 326). Джон Уайли и сыновья.